





IA locale vs cloud : quand faut-il internaliser ses LLM ?
Par PowerLab · Publié le · Mis à jour le
Vous utilisez ChatGPT, Claude ou une API cloud, et la facture grimpe — ou vos données vous empêchent de dormir. La question se pose : et si on faisait tourner l'IA chez nous ? Ce guide vous donne les critères concrets pour trancher, sans jargon inutile.
« IA locale », ça veut dire quoi ?
Faire tourner l'IA en local (on-premise), c'est héberger les modèles sur votre propre matériel — une workstation, un serveur GPU — plutôt que d'appeler une API distante. Concrètement, cela couvre :
- Des LLM open-weight (Llama, Qwen, Mistral…) servis en local pour le chat, la rédaction, l'analyse.
- Du RAG (« discutez avec vos documents ») : le modèle répond en s'appuyant sur vos fichiers, sans qu'ils quittent l'entreprise.
- Des agents qui automatisent des tâches métier.
Les modèles ouverts atteignent aujourd'hui un niveau suffisant pour la majorité des usages professionnels — ce qui rend le local crédible, pas seulement pour les géants de la tech.
Cloud vs local : le comparatif honnête
| Critère | Cloud (API) | IA locale |
|---|---|---|
| Démarrage | Immédiat, zéro matériel | Investissement initial |
| Coût à l'usage | Facture récurrente qui suit le volume | Coût fixe amorti, marginal ensuite |
| Données | Sortent de l'entreprise | Restent 100 % chez vous |
| Personnalisation | Limitée au fournisseur | Totale (fine-tuning, RAG, choix du modèle) |
| Performance | Dépend du réseau, files d'attente | Latence maîtrisée, disponibilité garantie |
| Maintenance | Gérée par le fournisseur | À votre charge (ou infogérée) |
Aucune option n'est « meilleure » dans l'absolu : tout dépend de votre profil d'usage.
Comment se calcule réellement une facture cloud
C'est le point le plus mal compris, et celui qui provoque les mauvaises surprises. Une API d'IA ne facture pas « à la question » mais au token — une unité qui correspond à peu près à trois quarts de mot en français. Et elle facture deux flux distincts :
- Les tokens d'entrée — tout ce que vous envoyez au modèle : votre question, l'historique de la conversation, et surtout les documents joints.
- Les tokens de sortie — la réponse générée, facturée trois à cinq fois plus cher que l'entrée selon les fournisseurs.
Tant qu'on discute avec le modèle, les volumes restent modestes. Le piège apparaît avec le RAG. Quand vous branchez un assistant sur vos documents, chaque question déclenche l'envoi des passages pertinents au modèle : une question de dix mots peut mobiliser plusieurs milliers de tokens d'entrée. Multipliez par le nombre de collaborateurs et par le nombre de questions quotidiennes, et le calcul initial — établi sur trois utilisateurs pilotes — n'a plus rien à voir avec la facture réelle.
En local, cette mécanique disparaît : le coût est fixe, indépendant du nombre de questions posées. Une machine amortie ne facture plus que son électricité, que vos équipes lui posent dix ou dix mille questions par jour. Voir le calcul détaillé et le simulateur.
Les modèles ouverts sont-ils au niveau des modèles propriétaires ?
C'est l'objection numéro un, et elle mérite une réponse chiffrée plutôt qu'une opinion. Sur l'indice d'intelligence Artificial Analysis relevé en juillet 2026, les meilleurs modèles propriétaires plafonnent autour de 60 points ; le meilleur modèle ouvert atteint 57. Trois points d'écart — et sur certaines épreuves spécialisées, comme le classement Frontend Code Arena, un modèle ouvert occupe même la première place.
Il y a deux ans, cet écart était béant. La trajectoire compte davantage que le classement du mois : ce qui relève du frontier aujourd'hui devient le modèle que vous ferez tourner chez vous dans deux ans, quand votre matériel, lui, en aura encore trois devant lui.
Mais la vraie réponse est ailleurs. Pour un usage documentaire, ce n'est pas la bonne question. Un assistant qui répond sur vos quatre cents procédures internes n'a pas besoin du meilleur modèle du monde : il a besoin d'un bon modèle qui a accès à vos documents. Le modèle le mieux classé, s'il n'a jamais vu vos contrats, produira une réponse moins utile qu'un modèle de 14 milliards de paramètres qui les a indexés. Sur vos données, c'est l'accès qui fait la qualité — pas le rang au benchmark.
Trois architectures possibles
Le choix n'est pas binaire. Dans les faits, trois montages coexistent et chacun a son domaine de pertinence.
Tout cloud
Pertinent pour démarrer, pour un usage occasionnel, ou quand le besoin n'est pas encore stabilisé. Vous ne payez que ce que vous consommez, sans immobilisation. C'est le bon choix tant que vous cherchez encore ce que l'IA peut vous apporter.
Tout local
Pertinent quand la confidentialité est une contrainte absolue — secteurs réglementés, propriété intellectuelle sensible — ou quand le volume rend la facture cloud structurellement plus chère que l'amortissement. Vous maîtrisez le modèle, sa version et sa disponibilité.
Hybride
C'est le montage le plus fréquent en pratique. Le local absorbe l'usage quotidien : celui qui coûte cher en récurrent et qui touche à vos documents. Le cloud reste disponible pour le ponctuel — un entraînement lourd une fois par trimestre, ou l'accès à un modèle géant que personne n'héberge. Vous conservez l'accès au frontier sans le payer toute l'année, et votre outil de travail quotidien ne dépend d'aucun fournisseur.
La méthode pour trancher
Plutôt qu'un débat général, quatre questions dans cet ordre donnent la réponse dans la quasi-totalité des cas.
- 1. Vos données peuvent-elles sortir ? Si la réponse est non — secret professionnel, données de santé, propriété industrielle — le débat s'arrête là. Le local n'est pas une optimisation, c'est un prérequis.
- 2. L'usage sera-t-il régulier ? Quelques requêtes par mois : restez au cloud. Un usage quotidien partagé par une équipe : le calcul bascule rapidement.
- 3. Combien de personnes l'utiliseront en même temps ? C'est ce qui détermine la configuration, bien plus que la taille du modèle. Un même modèle sert six personnes sur une machine d'entrée, une cinquantaine sur un serveur multi-GPU.
- 4. Avez-vous besoin de personnaliser ? RAG sur vos documents, fine-tuning sur votre métier, choix précis de la version du modèle : autant de choses que le cloud n'autorise que partiellement.
Si vous répondez « oui » aux questions 1 ou 2, l'IA locale mérite un chiffrage sérieux. Si vous répondez « non » aux deux, le cloud reste probablement le bon choix — et nous vous le dirons.
Quand l'IA locale gagne
Passez au local si vous cochez plusieurs de ces cases :
- Usage régulier et prévisible. Dès que vous sollicitez l'IA tous les jours, à plusieurs, le coût cloud cumulé dépasse vite l'amortissement d'une machine.
- Données confidentielles ou réglementées. Santé, juridique, finance, R&D : si vos documents ne doivent pas transiter par un tiers, le local n'est pas une option, c'est une obligation.
- Besoin de personnalisation. Fine-tuning sur votre métier, RAG sur votre base documentaire, choix précis du modèle.
- Recherche de performance stable. Pas de latence réseau, pas de bridage, pas de file d'attente GPU.
Quand le cloud reste le bon choix
Soyons équilibrés — le cloud garde des atouts : pour expérimenter avant d'investir, pour des pics ponctuels (un entraînement lourd par trimestre), et pour les modèles frontier les plus lourds que peu d'entreprises hébergent en interne. La bonne architecture est souvent hybride : le quotidien en local, le ponctuel dans le cloud.
Cloud ou local pour votre cas ?
Chiffrez votre seuil de bascule en quelques secondes.
Ouvrir le calculateur →Par où commencer, concrètement
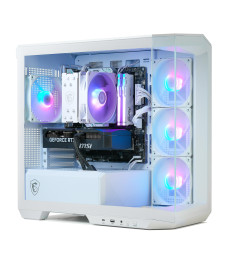
- Workstation IA pour un usage individuel ou une petite équipe. → Voir les workstations IA
- Serveur GPU dès que plusieurs utilisateurs partagent le modèle. → Voir les serveurs GPU
- Service de déploiement pour ne pas gérer la technique. → Voir les services IA
Questions fréquentes
L'IA locale est-elle vraiment moins chère que le cloud ?
Au-delà d'un certain volume, oui. Ordres de grandeur constatés : un poste individuel remplace environ 7 250 € de cloud par an et s'amortit en 17 mois ; un serveur pour une équipe de 5 à 15 personnes déplace près de 36 000 € par an et s'amortit en 17 mois (prix et tarifs cloud au 12/10/2026). Ensuite, la machine ne coûte plus que son électricité.
En dessous d'un usage régulier, le cloud reste moins cher — c'est arithmétique. Le point de bascule dépend de votre volume réel : le calculateur vous le donne avec vos propres chiffres.
Les modèles ouverts sont-ils au niveau de ChatGPT ou Claude ?
L'écart est aujourd'hui de trois points sur une échelle de soixante, selon l'indice Artificial Analysis de juillet 2026 — et un modèle ouvert est même premier sur certaines épreuves de code. Il y a deux ans, l'écart était considérable.
Surtout, pour un usage documentaire, la comparaison n'est pas la bonne. Un modèle qui a accès à vos documents produit une meilleure réponse qu'un modèle mieux classé qui ne les a jamais vus. C'est l'accès aux données qui fait la qualité de la réponse, pas le rang au classement.
Mes données restent-elles vraiment privées en local ?
Oui, et c'est une propriété de l'architecture, pas une promesse contractuelle. Le modèle s'exécute sur votre machine : ni le document, ni la question, ni la réponse ne transitent par Internet. Vous pouvez débrancher l'accès extérieur, l'assistant continue de fonctionner.
Conséquence directe : aucun sous-traitant, donc aucune politique de rétention à subir, aucune clause susceptible de changer, et aucun risque que vos données servent à entraîner le modèle d'un tiers.
Faut-il une équipe IA en interne ?
Non. La machine arrive avec le modèle chargé, l'interface prête et les accès configurés : vos équipes ouvrent un navigateur, exactement comme avec un service en ligne. L'installation, la formation, la supervision et les mises à jour peuvent être prises en charge.
Ce qui reste de votre côté : savoir ce que vous voulez obtenir. Un référent métier — souvent la personne qui connaît le mieux vos procédures — suffit pour indiquer quels documents indexer et qui doit y accéder.
Puis-je commencer petit puis grandir ?
Oui, et c'est la trajectoire que nous recommandons. Une workstation permet de valider l'usage sur un périmètre restreint, avec un investissement mesuré. Quand l'outil est adopté et que plusieurs personnes l'utilisent simultanément, on passe sur un serveur.
Un point à anticiper dès le premier achat : le châssis, l'alimentation et le refroidissement se dimensionnent au départ pour permettre l'ajout ultérieur de mémoire ou de cartes. Prévoir l'évolution coûte peu à la commande ; y revenir après peut imposer de changer la machine.
Que se passe-t-il si le modèle que j'utilise devient obsolète ?
Vous en installez un autre. C'est l'un des avantages les moins évoqués du local : le matériel et le modèle sont indépendants. Une machine achetée aujourd'hui fera tourner les modèles ouverts publiés dans deux ans, qui seront meilleurs à taille égale.
À l'inverse, dans le cloud, c'est le fournisseur qui décide : un modèle peut être déprécié ou modifié sans préavis, et vos réglages cessent de fonctionner. En local, vous ne changez de version que lorsque vous l'avez décidé et testé.
Et si je me trompe de dimensionnement ?
C'est le risque réel, et il se traite en amont plutôt qu'après coup. La variable qui décide n'est pas la taille du modèle mais le nombre d'utilisateurs simultanés : un modèle de 14 milliards de paramètres tient aussi bien sur une carte de 32 Go que sur un serveur, seul change le nombre de personnes servies en même temps.
C'est pourquoi le dimensionnement part de votre usage — combien de personnes, quels documents, quel type de tâches — et non d'un catalogue. Une machine sous-dimensionnée frustre les utilisateurs ; une machine surdimensionnée immobilise du capital sans bénéfice.
Un projet serveur ou IA en tête ?
Décrivez votre usage — on vous répond avec un dimensionnement et un devis sous 48 h ouvrées. Sans engagement, et si le cloud est plus pertinent dans votre cas, on vous le dira.