

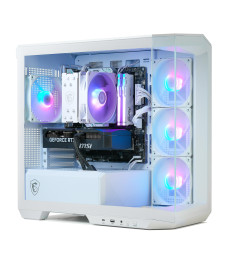
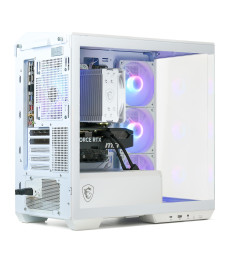




La puissance de l'IA locale, sur votre poste.
Exécutez LLM, génération image/vidéo et fine-tuning en local — sans cloud, sans fuite de données. Assemblées et testées en France, prêtes à produire.
Sur la machine à 9 999 € HT, un assistant qui répond sur vos procédures et vos contrats sert 5 personnes en même temps. Pas besoin d'un budget de grand groupe pour commencer — et le jour où l'équipe grandit, la gamme suit.
- Livrée prête — modèle chargé, interface web, accès configurés. Vous branchez, vous produisez.
- Testée 48 h en charge — burn-in avant expédition, pas après votre premier incident.
- Un interlocuteur — assemblage, SAV et pièces au même endroit, en France.
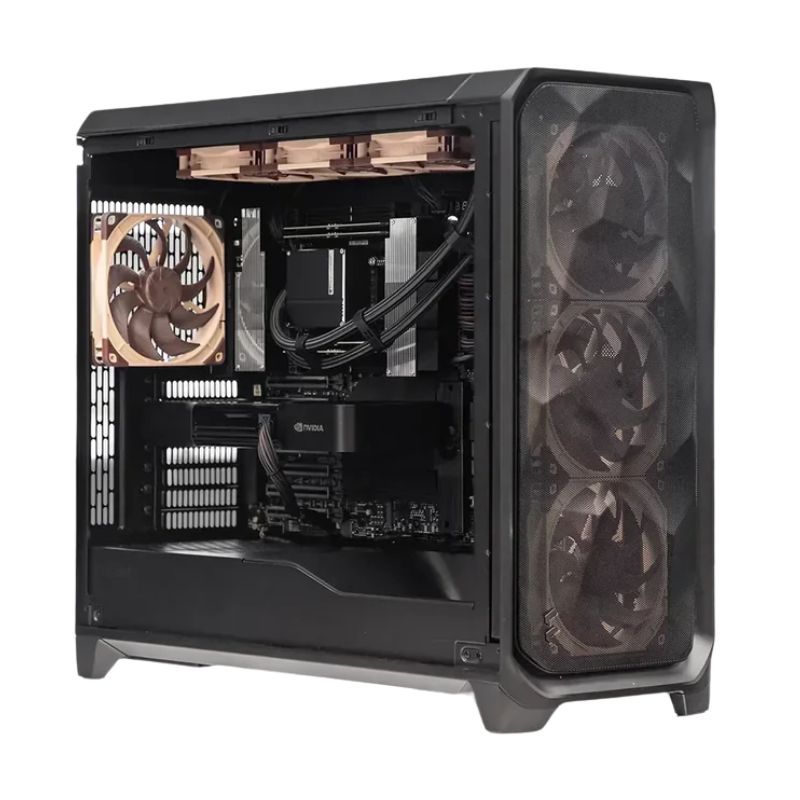
- GPU pro jusqu'à 96 Go
- Modèles locaux jusqu'à ~85 Go
- Stack IA préinstallée
- Burn-in + garantie inclus
Conçues pour ceux qui produisent avec l'IA
Créateurs & studios
Génération image/vidéo (ComfyUI, Flux), voix, à pleine cadence et en local.
Développeurs & ML
Assistants code, expérimentation, RAG et fine-tuning léger sur vos données.
Indépendants & cabinets IA
Un poste unique, confidentiel, sans abonnement cloud qui court.
Trois machines, trois échelles
Configs types pré-validées — dimensionnées au juste besoin. Chaque machine est assemblée sur commande et testée avant livraison.
Prix « à partir de » HT au 12/10/2026, confirmés sur devis : le prix des cartes graphiques évolue chaque semaine.

Neura Studio
- GPU1× 32 Go (RTX 5090)
- CPURyzen 9 / Core Ultra 9
- RAM64–96 Go DDR5
- Stockage2–4 To NVMe
- Idéal pourLLM ≤ 34B, image, RAG
Neura Studio Duo
- GPU2× 32 Go (RTX 5090) · 64 Go
- CPURyzen 9 / Threadripper
- RAM128 Go DDR5
- Stockage4 To NVMe
- Idéal pourÉquipe ≤ 15, LLM ≤ 50 Go, image ×2
Neura Studio Max
- GPU1× 96 Go (RTX PRO 6000 Blackwell)
- CPUAMD Threadripper
- RAM128–256 Go DDR5 ECC
- Stockage4–8 To NVMe
- Idéal pourPleine précision, multimodal, fine-tuning
Ce que chaque poste fait tourner, et pour combien de personnes
Modèles ouverts (Qwen, Gemma, GLM, DeepSeek, Mistral…), servis en local. Les trois dernières colonnes indiquent combien de personnes peuvent utiliser le modèle en même temps — c'est ce qui décide de la configuration, pas la taille du modèle. Au-delà, on passe sur un serveur GPU.
↔ Faites défiler le tableau horizontalement
| Modèle open-weight | Précision | VRAM | Neura Studio · 32 Go | Neura Studio Duo · 2×32 Go | Neura Studio Max · 96 Go |
|---|---|---|---|---|---|
| Qwen3.8 (27B) — n°1 des modèles ouverts < 40B | Q4 | ~18 Go | 5 personnes | 17 personnes | 25+ personnes |
| Gemma 4 (31B) — agents, résumés | Q4 | ~21 Go | 3 personnes | 14 personnes | 24 personnes |
| Qwen3.8 (27B) | Q8 — qualité quasi maximale | ~34 Go | — | 6 personnes | 12 personnes |
| Qwen3.8 (27B) | BF16 — pleine précision | ~65 Go | — | — | 3 personnes |
| Génération d'image (Qwen-Image, FLUX.2) | FP8 | ~24 Go | 1 poste | 2 rendus en parallèle | 1 poste, plus rapide |
| Qwen3.8-Flash-Next (180B · 6B actifs) — 5e modèle ouvert mondial | Q3 | ~82 Go | — | — | équipe réduite |
| GLM-5.3-Flash, DeepSeek V4.1 Flash (MoE géants) | — | 150 Go+ | → Serveur GPU | → Serveur GPU | → Serveur GPU |
Estimation à contexte de travail confortable, plafonnée par le débit réel du GPU. La génération d'image est un usage mono-poste : la carte accélère le rendu, elle ne sert pas plusieurs personnes à la fois. Estimations calculées, à confirmer sur votre usage. Modèles au classement Artificial Analysis du 12/10/2026.
Livrée configurée, testée, opérationnelle
Vous branchez, vous produisez. Pas de montage d'environnement, pas de galère de pilotes.
- OS & pilotes — Ubuntu ou Windows, CUDA prêt
- Stack IA préinstallée — Ollama, vLLM, ComfyUI, Open WebUI
- Burn-in 48 h — validation en charge avant expédition
- Garantie pro + prise en main incluse
- Assemblée en France — interlocuteur unique
Assemblé en France
Atelier, banc de test, burn-in : chaque poste sort validé.
Partenaire NVIDIA (NPN)
Accès direct aux GPU pro RTX Pro Blackwell et au support constructeur.
Évolutif
RAM, stockage, GPU : on fait grandir la machine avec vos besoins.
Workstations IA — vos questions
Quel modèle tourne sur une workstation ?
Qwen3.8 27B, le meilleur modèle ouvert de moins de 40 milliards de paramètres, tourne dès la Neura Studio (32 Go) pour 5 personnes en même temps. La Studio Max (96 Go) le fait tourner en pleine précision, ou pour plus de 25 personnes, et accueille Qwen3.8-Flash-Next, 5e modèle ouvert mondial, en version 3 bits. GLM-5.3-Flash et DeepSeek V4.1 Flash demandent un serveur GPU.
Windows ou Linux ?
Les deux sont possibles. Linux est recommandé pour l'inférence et le service de modèles ; Windows convient aux workflows créatifs. On préinstalle selon votre choix.
Puis-je faire du fine-tuning ?
Oui : du fine-tuning léger (LoRA / QLoRA) est possible sur la Studio Max. Pour de l'entraînement lourd, un serveur GPU est plus adapté.
Quelle différence entre Studio, Studio Duo et Studio Max ?
La mémoire GPU et sa répartition. La Studio (32 Go) couvre l'usage courant. Le Duo (2×32 Go) sert davantage de personnes en même temps sur les modèles moyens et fait tourner deux rendus image en parallèle. La Max (96 Go sur une seule carte) vise la pleine précision et les gros projets.
La machine est-elle évolutive ?
Oui : RAM, stockage et, selon le châssis, le GPU peuvent évoluer. On dimensionne au plus juste au départ, on étend ensuite.
Parlons de votre configuration
Réponse sous 48 h · sans engagement · devis sur mesure.
Parlons-en 30 minutes, cette semaine
Un échange de découverte, sans engagement. Vous décrivez ce que vous voulez faire, on vous dit ce qu'il vous faut.