




Calcul IA multi-GPU, de l'inférence à l'entraînement.
Servez des LLM à toute votre équipe, ou entraînez vos modèles — en rack, chez vous, sans dépendre du cloud. Dimensionnés au juste besoin, supportés en France.
Un Cluster fait tourner GLM-5.3-Flash et Qwen3.8-Flash-Next, 4e et 5e modèles ouverts les plus intelligents au monde, ou sert Qwen3.8 27B à plus de cinquante personnes en continu. À ce niveau d'usage, il remplace une facture cloud d'environ 36 000 € par an — et il est remboursé en 17 mois. Ensuite, il tourne pour le prix de l'électricité.
- Dimensionné sur vos modèles — on part de ce que vous devez faire tourner, pas d'un catalogue.
- La disponibilité est contractuelle — SLA, mémoire ECC, stock de pièces. Un serveur qui tombe bloque toute l'équipe, pas une personne.
- Burn-in 48 h en charge — testé avant expédition, pas chez vous.
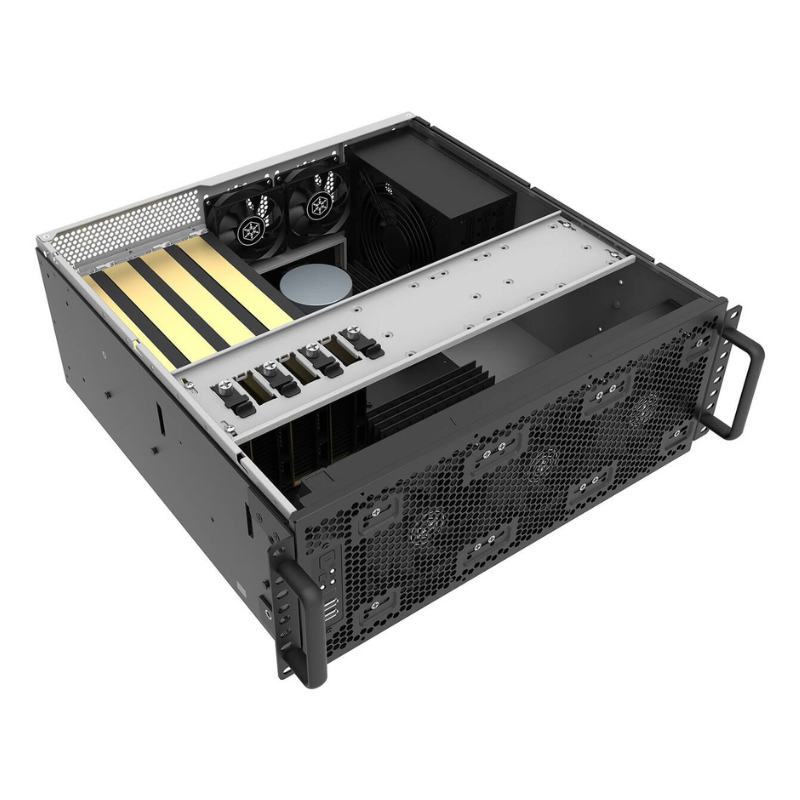
- GPU 2 à 4× 96 Go
- Modèles ouverts de pointe multi-utilisateurs
- Entraînement & fine-tuning
- Rack, ECC, SLA inclus
Quand un poste ne suffit plus
Startups IA
Montée en charge : servir un modèle à de nombreux utilisateurs, entraîner, itérer vite.
PME multi-utilisateurs
Un assistant IA interne partagé par toute l'équipe, en continu et en local.
Studios de production
Rendu et génération à cadence soutenue, pipelines parallèles.
Deux paliers de serveur
Configurations rack pré-validées, assemblées sur commande, burn-in et validées avant livraison. Dimensionnement précis selon vos modèles et votre nombre d'utilisateurs.
Prix « à partir de » HT au 12/10/2026, confirmés sur devis : le prix des cartes graphiques évolue chaque semaine.
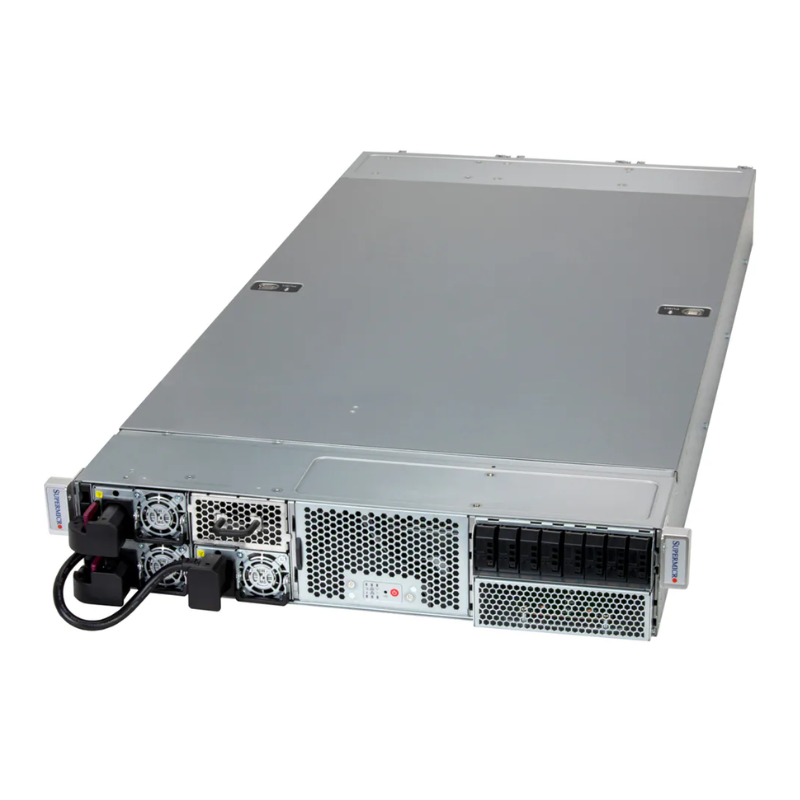
Neura Cluster
- GPU2× 96 Go (RTX PRO 6000)
- CPUAMD Threadripper PRO
- RAM256 Go ECC
- Réseau10 / 25 GbE
- FormatRack, hyperviseur Proxmox/VMware
Neura Datacenter
- GPU4× 96 Go (RTX PRO 6000)
- CPUAMD EPYC / Intel Xeon
- RAM512 Go+ ECC
- Réseau25 / 100 GbE
- FormatRack redondé, refroidissement optimisé
Ce que chaque serveur fait tourner, et pour combien de personnes
Du modèle compact servi à toute l'équipe jusqu'aux 4e, 5e et 6e modèles ouverts mondiaux (classement Artificial Analysis, 12/10/2026). Les deux dernières colonnes indiquent combien de personnes peuvent utiliser le modèle en même temps — c'est ce qui décide de la configuration.
↔ Faites défiler le tableau horizontalement
| Modèle open-weight | Précision | VRAM | Neura Cluster · 2×96 Go | Neura Datacenter · 4×96 Go |
|---|---|---|---|---|
| Qwen3.8 (27B) / Gemma 4 (31B) — agents, assistants | Q4 | ~18–21 Go | 50+ personnes | 100+ personnes |
| Qwen3.8 (27B) | Q8 — qualité quasi maximale | ~34 Go | 32 personnes | 71 personnes |
| Qwen3.8 (27B) | BF16 — pleine précision | ~65 Go | 13 personnes | 34 personnes |
| Qwen3.8-Flash-Next (180B · 6B actifs) — 5e modèle ouvert mondial | Q3 | ~82 Go | équipe | équipe |
| GLM-5.3-Flash (320B · 18B actifs) — 4e modèle ouvert mondial | Q3 | ~150 Go | équipe réduite | équipe |
| DeepSeek V4.1 Flash (552B · 16B actifs) — 6e modèle ouvert mondial | FP4 officiel, Engram sur NVMe | ~310 Go | — | équipe réduite |
| MiMo-V2.6-Pro, GLM-5.3, Kimi K3 (1 000 à 2 800B) | — | 420 Go à 1,4 To | — | hors gabarit |
| Entraînement / fine-tuning | QLoRA / natif | — | selon la taille | natif |
Estimation à contexte de travail confortable, plafonnée par le débit réel des GPU. « Équipe » / « équipe réduite » : pour les MoE géants, le nombre d'utilisateurs simultanés dépend fortement du contexte et se mesure au cas par cas. DeepSeek V4.1 Flash tourne dans sa version officielle, sa table Engram (~203 Go) laissée sur disque NVMe ; outillage encore récent, mise en service après validation. Les trois premiers modèles ouverts mondiaux (MiMo-V2.6-Pro, GLM-5.3, Kimi K3) dépassent la mémoire d'un serveur 4 GPU. Estimations calculées, à confirmer sur votre usage.
Conçu pour tourner en continu
En B2B, une première panne non traitée détruit la réputation. Nos serveurs sont pensés pour la disponibilité — la fiabilité est contractuelle.
- Mémoire ECC — corrige les erreurs silencieuses (critique en entraînement)
- Multi-GPU + refroidissement maîtrisé, alimentation redondée
- Hyperviseur — Proxmox / VMware, virtualisation & isolation
- Burn-in + SLA + stock de pièces pour remise en route rapide
- Assemblé en France — interlocuteur unique, infogérance en option
Assemblé en France
Atelier, banc de test, burn-in en charge avant livraison.
Partenaire NVIDIA (NPN)
Accès direct aux GPU pro RTX Pro Blackwell et au support constructeur.
Infogérance & SLA
Supervision, mises à jour, support prioritaire — Neura Deploy.
Serveurs GPU — vos questions
Combien de GPU pour X utilisateurs ?
Cela dépend du modèle et du débit visé. En règle générale, 2 GPU (Cluster) servent Qwen3.8 27B à plus de cinquante personnes, Qwen3.8-Flash-Next à une équipe, ou GLM-5.3-Flash à une équipe réduite ; 4 GPU (Datacenter) font tourner GLM-5.3-Flash confortablement et DeepSeek V4.1 Flash, et visent la forte concurrence et l'entraînement. On dimensionne précisément à votre cas.
Inférence ou entraînement, même machine ?
Les deux sont possibles. L'inférence multi-utilisateurs privilégie la VRAM et la bande passante ; l'entraînement/fine-tuning demande davantage de calcul et de RAM. On oriente la config selon votre usage dominant.
Rack ou tour ?
Nos serveurs GPU sont en format rack (densité, refroidissement, évolutivité). Une variante tour est possible pour un local sans baie.
Consommation et refroidissement ?
Un serveur multi-GPU tire plusieurs kW sous charge. On dimensionne alimentation, refroidissement et, si besoin, on vous conseille sur l'installation électrique et la ventilation du local.
Peut-on mutualiser le serveur entre équipes ?
Oui : via l'hyperviseur et un serveur d'inférence (vLLM), un même serveur sert plusieurs utilisateurs et projets en parallèle, avec isolation.
Dimensionnons votre serveur
Réponse sous 48 h · sans engagement · devis et dimensionnement sur mesure.
Parlons-en 30 minutes, cette semaine
Un échange de découverte, sans engagement. Vous décrivez ce que vous voulez faire, on vous dit ce qu'il vous faut.