





Tout ce qu'on nous demande
Matériel, modèles, données, délais, garantie — les réponses aux questions les plus courantes. Une question sans réponse ? Écrivez-nous.
Pourquoi faire tourner l'IA en local plutôt que dans le cloud ?
Pour quatre raisons, dans cet ordre d'importance selon les entreprises. La confidentialité : vos documents et vos questions ne quittent jamais votre réseau, ce qui règle la question RGPD sans clause à négocier. Le coût : le cloud facture chaque requête, une machine s'amortit puis ne coûte plus que l'électricité. La performance : pas de file d'attente ni de latence réseau, le débit est le vôtre. Le contrôle : vous choisissez le modèle, sa version, et vous le personnalisez sur vos données.
Ce n'est pas systématiquement le bon choix. En dessous d'un usage régulier, le cloud reste moins cher — c'est arithmétique, et nous vous le dirons si c'est votre cas. Voir le comparatif complet.
L'IA locale est-elle vraiment moins chère que le cloud ?
Au-delà d'un certain volume, oui — et le basculement arrive plus vite qu'on ne le pense. Ordres de grandeur constatés : un poste individuel remplace environ 7 250 € de cloud par an et s'amortit en 17 mois ; un serveur pour une équipe de 5 à 15 personnes déplace environ 36 000 € par an et s'amortit en 17 mois (prix et tarifs cloud au 12/10/2026). Ensuite, la machine continue de tourner pour le prix de l'électricité.
Trois postes font déraper la facture cloud et n'apparaissent pas dans le devis initial : les documents renvoyés au modèle à chaque question (dans un assistant RAG, ce sont des tokens facturés à chaque fois), l'adoption qui multiplie les utilisateurs après la phase pilote, et le tarif qui n'est contractuellement garanti nulle part. Calculez votre seuil de bascule.
Peut-on combiner local et cloud ?
Oui, et c'est le montage que nous mettons en place le plus souvent. Le principe : le local absorbe l'usage quotidien — celui qui coûte cher en récurrent et qui touche vos documents sensibles — pendant que le cloud reste disponible pour le ponctuel : un entraînement lourd une fois par trimestre, ou l'accès à un modèle géant que personne ne peut héberger.
L'intérêt n'est pas seulement financier. Vous gardez l'accès aux modèles frontier sans les payer toute l'année, et vous ne dépendez d'aucun fournisseur pour votre outil de travail quotidien. Si votre accès cloud tombe ou change de tarif, votre assistant interne continue de fonctionner.
Quelle machine pour mon besoin ?
La question qui décide n'est pas la taille du modèle, mais combien de personnes l'utiliseront en même temps. Qwen3.8 27B — meilleur modèle ouvert de moins de 40 milliards de paramètres, largement suffisant pour un assistant sur vos documents — tient aussi bien sur une carte de 32 Go que sur un serveur à 384 Go. Ce qui change, c'est le nombre d'utilisateurs simultanés.
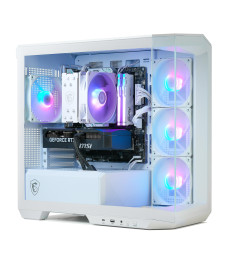
Les repères : Neura Studio (32 Go, dès 9 999 € HT) sert 5 personnes en même temps sur cet assistant — c'est notre configuration la plus vendue en PME. Studio Duo (2×32 Go) monte à 17 personnes. Studio Max (96 Go) monte à 25 personnes, ou fait tourner le modèle en pleine précision. Cluster (2×96 Go) sert plus de cinquante personnes et fait tourner GLM-5.3-Flash, 4e modèle ouvert mondial ; Datacenter (4×96 Go) ajoute DeepSeek V4.1 Flash, 6e mondial. Dès la Studio Max, Qwen3.8-Flash-Next (5e mondial) tourne en version 3 bits. Le NAS Store est le socle de données qui alimente l'ensemble. Décrivez votre usage, nous dimensionnons — c'est notre métier, pas le vôtre.
Combien de VRAM pour un LLM 70B en local ?
Environ 48 Go en 4-bit, la précision la plus courante en local. La règle de calcul : comptez ~0,5 Go par milliard de paramètres en 4-bit, ~1 Go en 8-bit, ~2 Go en FP16, puis ajoutez 15 à 20 % pour la mémoire de contexte (les conversations en cours).
Une carte professionnelle de 96 Go le charge donc seule, avec de la marge pour environ 7 utilisateurs simultanés. Pour servir un 70B à une équipe entière en continu, on passe sur un serveur multi-GPU : 2 cartes pour une vingtaine de personnes, 4 pour une cinquantaine. Voir le guide de dimensionnement.
Les machines sont-elles évolutives ?
Oui, mais pas également sur tous les composants — autant être précis. La RAM et le stockage évoluent sans difficulté sur toutes nos configurations. Le GPU dépend du châssis et de l'alimentation : nous dimensionnons dès le départ le boîtier, le refroidissement et l'alimentation pour permettre l'ajout ultérieur, quand c'est votre trajectoire.
C'est un point à arbitrer à la commande, pas après. Prévoir l'évolution coûte peu à l'achat ; y revenir plus tard peut imposer de changer le châssis. Dites-nous où vous pensez être dans deux ans, nous en tenons compte dans la configuration initiale.
NVIDIA uniquement ?
Oui, sur la partie GPU, et c'est un choix assumé. L'écosystème logiciel de l'IA — CUDA, vLLM, PyTorch, la quasi-totalité des projets open source — est développé et testé en priorité sur NVIDIA. Une carte concurrente peut afficher de bonnes caractéristiques sur le papier et poser des problèmes de compatibilité ou de performance sur un modèle récent.
Nous sommes membres du NVIDIA Partner Network, ce qui nous donne accès au support constructeur et aux gammes professionnelles (RTX PRO Blackwell). Côté CPU en revanche, nous travaillons aussi bien avec AMD EPYC qu'avec Intel Xeon selon la configuration.
Quels modèles peut-on faire tourner ?
Tous les modèles à poids ouverts : Qwen3.8, Gemma 4, GLM-5.3-Flash, DeepSeek V4.1 Flash, Mistral et leurs déclinaisons. Le cœur de production tient sur une seule carte, avec des modèles comme Qwen3.8 27B (n°1 des modèles ouverts de moins de 40 milliards de paramètres selon Artificial Analysis) — c'est là que se trouve le meilleur rapport qualité / débit / coût, et cela couvre l'immense majorité des usages professionnels : assistant sur documents, analyse, rédaction, code, support.
Les modèles géants sont une autre affaire. Kimi K3, par exemple, compte 2 800 milliards de paramètres et demande environ 1 400 Go de mémoire en 4-bit — près de quatre fois notre configuration la plus haute. Ses poids sont publics, mais il ne tourne pas en entreprise. Nos machines font en revanche tourner GLM-5.3-Flash (Cluster et Datacenter), Qwen3.8-Flash-Next (dès la Studio Max) et DeepSeek V4.1 Flash (Datacenter), 4e, 5e et 6e modèles ouverts les plus intelligents au monde. Voir quel modèle tourne sur quelle machine.
Les modèles ouverts sont-ils moins bons que ChatGPT ou Claude ?
Un écart existe. Sur l'indice d'intelligence Artificial Analysis relevé le 12/10/2026, le meilleur modèle propriétaire (Claude Opus 5.5) atteint 58 et le meilleur modèle ouvert (MiMo-V2.6-Pro) 46. Mais les modèles ouverts progressent vite : GLM-5.3-Flash (42), Qwen3.8-Flash-Next (40) et DeepSeek V4.1 Flash (39), qui tournent sur nos machines, figurent parmi les six meilleurs modèles ouverts au monde.
Mais la vraie réponse est ailleurs : ce n'est pas la bonne question. Un assistant qui répond sur vos 400 procédures internes n'a pas besoin du meilleur modèle du monde, il a besoin d'un bon modèle qui a accès à vos documents. Le meilleur modèle du monde, s'il n'a jamais vu vos contrats, donnera une moins bonne réponse qu'un modèle local de 27 milliards de paramètres qui les a indexés. Sur vos données, c'est l'accès qui fait la qualité.
Quelle différence entre RAG et fine-tuning ?
Le RAG donne au modèle accès à vos documents au moment de la question : il cherche les passages pertinents, les lui transmet, et le modèle répond en citant ses sources. Vos documents restent à part, vous les mettez à jour quand vous voulez — ajouter une procédure prend quelques minutes et ne demande aucun réentraînement.
Le fine-tuning modifie le modèle lui-même pour lui apprendre un ton, un format ou un vocabulaire métier. C'est plus lourd (données d'entraînement à préparer, temps de calcul) et il faut recommencer à chaque évolution. Dans neuf cas sur dix, le RAG répond au besoin. Le fine-tuning devient pertinent quand vous avez une exigence de style ou de format très spécifique — et les deux se combinent très bien.
La quantization dégrade-t-elle la qualité ?
Marginalement. La quantization réduit la précision des poids du modèle pour qu'il tienne dans moins de mémoire : en 4-bit, un modèle occupe quatre fois moins de place qu'en pleine précision. La perte mesurée sur les principaux benchmarks est de l'ordre de 1 à 3 % — imperceptible sur les usages courants.
C'est le standard en local, et c'est ce qui rend l'IA locale accessible : sans quantization, un modèle 70B demanderait près de 140 Go au lieu de 48. En pratique, il vaut mieux un modèle 70B en 4-bit qu'un modèle 14B en pleine précision. Quand la qualité maximale compte, on passe en 8-bit — au prix de deux fois plus de mémoire, donc de moins d'utilisateurs simultanés.
Faut-il une équipe IA en interne ?
Non — et c'est précisément ce que nous vendons. La machine arrive avec le modèle déjà chargé, l'interface web prête et les accès configurés : vos équipes ouvrent un navigateur et posent leurs questions, exactement comme avec ChatGPT. Elles n'ouvriront jamais un terminal. Nous assurons l'installation sur site, la prise en main, la supervision, les mises à jour de modèles et le SAV.
Ce qui reste de votre côté : savoir ce que vous voulez que l'IA fasse. Un référent interne — souvent la personne qui connaît le mieux vos procédures — suffit pour nous indiquer quels documents indexer et qui doit y avoir accès. Aucune compétence technique n'est requise, ni au démarrage ni ensuite.
Combien de temps pour déployer une IA interne ?
Il faut distinguer deux délais. Le matériel : nous assemblons sur commande, sans stock dormant, ce qui représente généralement 2 à 5 semaines selon la configuration et la disponibilité des GPU — le délai ferme est confirmé au devis. Le déploiement : une fois la machine prête, l'essentiel du travail a déjà été fait en atelier (modèle chargé, interface montée, accès créés).
Sur site, il reste la mise en service, la vérification sur vos vrais documents et la séance de prise en main avec vos équipes. Un premier périmètre utile — un assistant qui répond sur un corpus documentaire défini — est opérationnel rapidement ; l'élargissement à d'autres cas d'usage se fait ensuite, par étapes. Voir le détail des délais.
Formez-vous nos équipes ?
Oui, la prise en main est incluse dans la mise en route. Ce n'est pas une documentation à lire : c'est une séance de travail sur vos cas réels, avec vos documents et vos questions types. À la fin, vos collaborateurs savent s'en servir.
Nous couvrons aussi ce qui fait la différence à l'usage : comment formuler une demande pour obtenir une bonne réponse, comment vérifier les sources citées, et surtout ce qu'il ne faut pas attendre de l'outil. Un utilisateur qui comprend les limites de l'IA lui fait davantage confiance là où elle est fiable.
Comment se passent les mises à jour de modèles ?
Sur demande, ou en continu si vous prenez l'infogérance. Le principe : nous ne basculons jamais votre modèle de production sans validation. Une nouvelle version est déployée en parallèle, testée sur vos propres cas d'usage, et vous décidez du basculement.
C'est un vrai avantage du local, et il est souvent sous-estimé : votre modèle ne change que quand vous le décidez. Dans le cloud, un fournisseur peut modifier ou déprécier un modèle du jour au lendemain — vos prompts, vos réglages et vos habitudes cessent de fonctionner sans que vous ayez rien demandé.
Quels délais de livraison ?
Généralement 2 à 5 semaines, selon la configuration et la disponibilité des GPU. Nous assemblons sur commande et ne gardons pas de machines dormantes en stock : les composants sont approvisionnés une fois le devis validé, ce qui garantit des pièces récentes et un prix au plus juste plutôt qu'une machine montée il y a six mois.
Le déroulé : étude et devis sous 48 h, validation de la configuration avec vous, approvisionnement (1 à 3 semaines), assemblage et burn-in en atelier (quelques jours), puis livraison. Le délai ferme est communiqué au devis, pas estimé après coup, et nous vous alertons si un composant prend du retard. Voir le détail étape par étape.
Quelle garantie et quel SAV ?
Garantie professionnelle sur le matériel, SLA contractuel sur la disponibilité, et un stock de pièces pour permettre une remise en route rapide sans attendre un réapprovisionnement constructeur. Un seul interlocuteur, en France, pour l'assemblage comme pour le SAV.
Cela compte davantage sur un serveur que sur un poste : quand une workstation tombe, une personne est bloquée ; quand un serveur d'inférence tombe, c'est toute l'équipe qui perd son outil de travail. C'est pourquoi la disponibilité est contractuelle et non « au mieux ». Le niveau exact de SLA est défini avec vous selon la criticité de votre usage.
Proposez-vous de l'infogérance ?
Oui, en option et sur devis. Le périmètre type comprend la supervision de la machine, les mises à jour de modèles avec validation avant bascule, le support prioritaire et le suivi des correctifs de sécurité. Vous utilisez l'IA, nous gardons la technique en état de marche.
Ce n'est pas obligatoire. Une machine correctement déployée fonctionne sans intervention pendant des mois. L'infogérance devient pertinente quand l'outil est passé en production, que plusieurs équipes en dépendent, ou que vous n'avez pas d'informaticien interne pour intervenir en cas de besoin.
Où sont assemblées les machines ?
En France, dans notre atelier. Chaque machine est montée à la main, câblée, puis passée au banc de test et en burn-in 48 h en charge avant expédition. Cette étape est là pour que les défauts de jeunesse — un composant fragile, un contact imparfait — se révèlent chez nous et non chez vous, trois semaines après la mise en production.
C'est aussi ce qui permet d'avoir un interlocuteur unique : la personne qui a monté votre machine appartient à l'équipe qui la supportera. Pas d'intermédiaire, pas de renvoi vers un constructeur à l'autre bout du monde.
Mes données restent-elles vraiment privées ?
Oui, et c'est une propriété de l'architecture — pas une promesse commerciale. Le modèle est stocké sur la machine et s'exécute sur son GPU. Quand un collaborateur pose une question, le calcul se fait dans vos murs : ni le document, ni la question, ni la réponse ne transitent par Internet. Vous pouvez débrancher le câble réseau externe, l'assistant continue de fonctionner.
Concrètement : aucun sous-traitant, donc aucune politique de rétention subie, aucune clause qui change du jour au lendemain, aucun risque que vos données servent à entraîner le modèle d'un tiers. Nous fournissons la journalisation des accès — qui a consulté quoi, et quand — pour vos obligations RGPD.
Est-ce adapté aux secteurs régulés ?
C'est souvent le seul montage qui passe sans discussion. Santé, juridique, finance, secteur public : dès qu'un dossier patient, un dossier client ou une pièce contractuelle entre dans le périmètre, l'IA locale évite tout le travail d'analyse d'impact, de clauses de sous-traitance et de localisation des données qu'impose une solution cloud.
Nous ne délivrons pas de certification et nous ne nous substituons pas à votre DPO : le RGPD s'apprécie sur l'ensemble de votre traitement, pas sur le seul choix d'infrastructure. Ce que nous garantissons, c'est que la donnée ne quitte pas votre réseau — le point le plus difficile à démontrer avec le cloud, et le premier que vous demandera un auditeur.
Peut-on cloisonner les accès à l'IA interne ?
Oui, et à deux niveaux distincts. L'accès à l'outil : authentification, profils utilisateurs, journalisation des requêtes. L'accès aux contenus : on définit quels documents chaque profil peut interroger, ce qui évite qu'un assistant remonte des données RH ou des documents de direction à quelqu'un qui n'y aurait pas accès dans votre arborescence.
Ce second point est celui qu'on oublie le plus souvent, et c'est le plus sensible. Un assistant RAG mal cloisonné devient un moteur de recherche qui ignore vos permissions : il peut restituer, dans une réponse formulée naturellement, une information à laquelle l'utilisateur n'aurait jamais eu accès en ouvrant le fichier. Nous cadrons ce périmètre dès le déploiement.
Une question précise sur votre cas ?
Réponse sous 48 h · sans engagement.